
Hay una pregunta que aparece tarde o temprano en cualquier sistema que crece: ¿qué hacemos cuando un montón de partes de la aplicación necesitan enterarse de lo mismo, al mismo tiempo, sin que una le pregunte constantemente a la otra "¿pasó algo nuevo?"? Ahí es donde entra Kafka.
Apache Kafka es una plataforma de streaming de eventos distribuida: un sistema pensado para recibir datos que llegan de forma continua —clics en una web, transacciones, lecturas de sensores, logs de una aplicación— y entregarlos, en orden, a quien los necesite, sin importar si son diez consumidores o diez mil eventos por segundo.
El problema que Kafka vino a resolver
Pensá en un e-commerce mediano. Cada vez que alguien agrega un producto al carrito, tenés que:
Actualizar el inventario disponible.
Registrar el evento para el sistema de recomendaciones.
Mandarle una señal al sistema de analítica en tiempo real.
Eventualmente, avisarle al equipo de marketing si ese carrito queda abandonado.
La forma ingenua de resolver esto es que el servicio de "carrito" le hable directamente a cada uno de esos cuatro sistemas. Funciona al principio, pero se vuelve frágil rápido: si el sistema de recomendaciones está caído, ¿se cae también el carrito? Si mañana aparece un quinto sistema que necesita enterarse de lo mismo, ¿hay que tocar el código del carrito de nuevo?
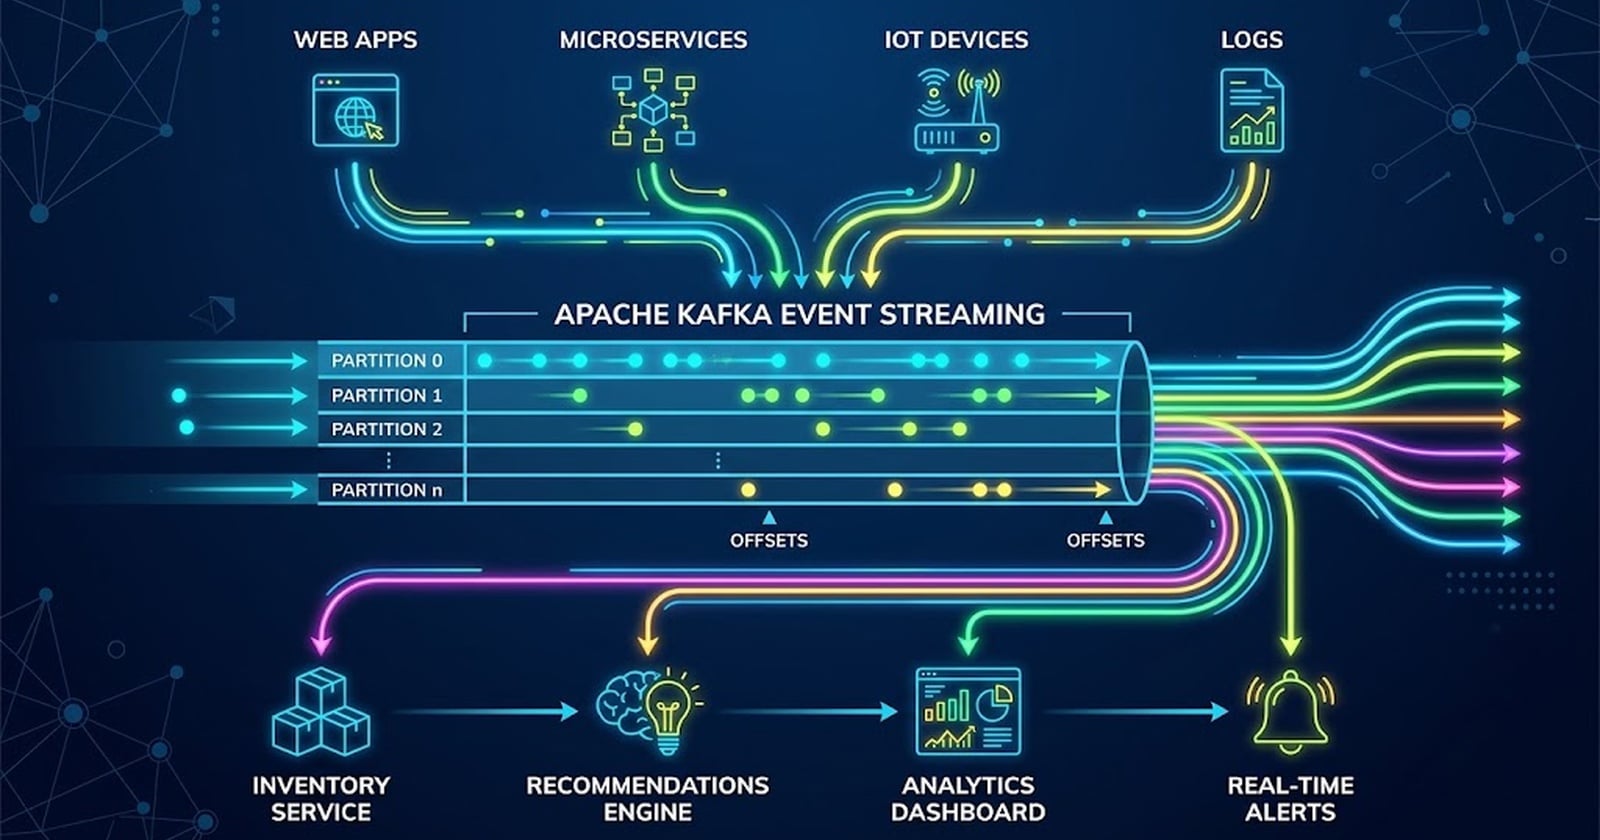
Kafka propone otra cosa: el carrito publica un evento ("se agregó el producto X") en un canal central, y cada sistema interesado se suscribe a ese canal y lee a su propio ritmo. El carrito no sabe ni le importa quién está escuchando. Se puede agregar un sistema nuevo sin tocar una línea del que ya existe.
Cómo funciona por dentro: el truco de las particiones
Antes de Kafka, básicamente había dos formas de mandar mensajes entre sistemas, cada una con una limitación clara:
Colas de mensajes tradicionales: cada mensaje lo procesa un solo consumidor, y podés sumar consumidores en paralelo para repartir la carga. El problema es que no hay "varios suscriptores" reales — una vez que alguien toma el mensaje, se acabó, nadie más lo ve.
Publicación-suscripción (pub/sub): todos los suscriptores reciben una copia de cada mensaje. Buenísimo para tener múltiples sistemas escuchando lo mismo, pero como cada suscriptor procesa todo, no sirve para repartir el trabajo entre varias instancias de un mismo servicio.
Kafka combina ambas ideas con un concepto central: el tema particionado (topic, en la jerga). Un tema es, básicamente, un registro ordenado de eventos — pensalo como un archivo de log al que solo se le puede agregar contenido al final, nunca modificarlo. Ese registro se divide en particiones, y cada partición se distribuye entre distintos servidores (brokers) del clúster.
Acá está la parte inteligente: dentro de un mismo grupo de consumidores, cada partición se le asigna a un único consumidor (como en una cola), lo que permite repartir el trabajo. Pero distintos grupos de consumidores pueden leer el mismo tema de forma completamente independiente (como en pub/sub), cada uno a su propio ritmo, sin pisarse entre sí.
Un ejemplo concreto ayuda a que esto quede claro. Supongamos un tema pedidos con 4 particiones:
El grupo de consumidores "inventario" tiene 2 instancias corriendo. Kafka le asigna 2 particiones a cada una, y entre las dos procesan los 4 flujos de pedidos en paralelo, sin duplicar trabajo.
El grupo de consumidores "analítica" es un grupo totalmente distinto, con su propia instancia. Lee las mismas 4 particiones, empezando desde donde él quiera (incluso puede "rebobinar" y volver a leer pedidos de hace una semana), sin afectar en absoluto lo que hace el grupo de inventario.
Esta capacidad de "rebobinar" es otro punto que distingue a Kafka de una cola tradicional: los mensajes no desaparecen apenas se leen. Quedan guardados en disco durante el tiempo que configures (por defecto, hasta que se llene el espacio asignado; podés poner un límite de retención de, por ejemplo, 7 días), así que un consumidor nuevo puede aparecer meses después y reprocesar todo el historial si lo necesita.
Los offsets: cómo Kafka sabe qué leíste ya
Cada partición numera sus mensajes en orden estricto de llegada, con un identificador que se llama offset. Cada consumidor guarda (y Kafka lo persiste) hasta qué offset leyó por última vez en cada partición. Esto es lo que le permite a un consumidor caerse, reiniciarse, y retomar exactamente donde había quedado, en vez de perder mensajes o reprocesar todo desde cero.
Partición 0: [0][1][2][3][4][5][6] ← el consumidor va por el offset 4
Partición 1: [0][1][2][3][4][5]    ← el consumidor va por el offset 2
Esto también es lo que hace posible el "replay" que mencionamos antes: si necesitás reprocesar los últimos tres días de eventos porque encontraste un bug en cómo los estabas interpretando, simplemente movés el offset del consumidor hacia atrás y Kafka te vuelve a entregar todo desde ahí.
Un ejemplo de código, para bajarlo a tierra
Un productor mínimo en Python, usando la librería kafka-python:
from kafka import KafkaProducer
import json

productor = KafkaProducer(
    bootstrap_servers=["localhost:9092"],
    value_serializer=lambda v: json.dumps(v).encode("utf-8")
)

evento = {"tipo": "producto_agregado", "carrito_id": "abc123", "producto_id": 42}
productor.send("carritos", value=evento)
productor.flush()
Y un consumidor perteneciente a un grupo llamado inventario, que procesa esos mismos eventos:
from kafka import KafkaConsumer
import json

consumidor = KafkaConsumer(
    "carritos",
    bootstrap_servers=["localhost:9092"],
    group_id="inventario",
    value_deserializer=lambda v: json.loads(v.decode("utf-8"))
)

for mensaje in consumidor:
    evento = mensaje.value
    print(f"Actualizando stock del producto {evento['producto_id']}")
    # acá iría la lógica real de descuento de stock
Si levantás una segunda instancia de este mismo consumidor, con el mismo group_id, Kafka reparte automáticamente las particiones del tema carritos entre ambas — sin que tengas que coordinar nada manualmente.
Las cuatro APIs de Kafka
Kafka no es solo "mandar y recibir mensajes". Expone cuatro herramientas distintas, cada una pensada para un tipo de trabajo:
Producer API: para publicar eventos en un tema (el ejemplo de arriba).
Consumer API: para suscribirse a uno o varios temas y procesarlos.
Streams API: para escribir aplicaciones que transforman un flujo de eventos en otro, en tiempo real — por ejemplo, tomar el tema
carritosy generar un tema derivadocarritos_por_categoria, agregando y agrupando sobre la marcha.Connect API: para conectar Kafka con sistemas externos (bases de datos, sistemas de archivos, otros servicios) sin tener que escribir vos mismo el código de integración — hay conectores ya hechos para la mayoría de las bases de datos populares.
Lo que cambió con Kafka 4.0
Vale la pena detenerse en la versión 4.0 (marzo de 2025) porque trajo tres cambios que modifican bastante la forma en que se piensa a Kafka hoy — y dos de ellos conectan directo con puntos que ya tocamos en este artículo.
Adiós a ZooKeeper. Durante más de una década, cualquier clúster de Kafka necesitaba correr junto a Apache ZooKeeper, un servicio aparte que se encargaba de coordinar metadatos del clúster (qué broker es líder de qué partición, qué configuraciones hay activas, etc.). Eso cambió: a partir de Kafka 4.0 se eliminó por completo el soporte de ZooKeeper, y el modo KRaft (Kafka Raft) pasó a ser la única forma de operar un clúster. KRaft mueve esa coordinación de metadatos a un protocolo de consenso construido nativamente dentro de Kafka, en vez de depender de un sistema externo. En la práctica, esto significa clústeres más simples de desplegar y operar (un componente menos que mantener vivo y actualizado) y arranques más rápidos. Si estás por levantar un clúster desde cero hoy, ya ni te vas a topar con la opción de usar ZooKeeper — y si tenés uno viejo corriendo con ZooKeeper, migrar a KRaft es, a esta altura, obligatorio para poder actualizar a versiones nuevas.
Rebalanceos mucho menos disruptivos (KIP-848). Volvamos un momento a los grupos de consumidores que explicamos más arriba. Hasta esta versión, cada vez que un consumidor se sumaba o se caía de un grupo, Kafka disparaba un rebalanceo de tipo "stop-the-world": todo el grupo dejaba de procesar mensajes mientras se reasignaban las particiones entre los consumidores restantes. En clústeres grandes, con muchos consumidores entrando y saliendo (deploys, autoescalado, caídas puntuales), esto generaba picos de latencia recurrentes. El nuevo protocolo de rebalanceo, ya disponible de forma general desde la 4.0, resuelve esto reasignando particiones de forma incremental en vez de detener todo el grupo — el resultado son rebalanceos bastante menos disruptivos, algo que se nota especialmente en sistemas con alta rotación de instancias de consumidores.
Kafka empieza a hablar el idioma de las colas tradicionales (KIP-932). Este es el que más se conecta con la comparación que hicimos con RabbitMQ. Kafka 4.0 incluyó, como función en acceso temprano (no recomendada para producción en esa versión), un concepto nuevo llamado share groups: grupos de consumidores que ya no están atados a la regla de "una partición, un consumidor" de los grupos tradicionales. Con share groups, varios consumidores pueden leer cooperativamente de las mismas particiones, con confirmación (acknowledgment) por mensaje individual — el comportamiento típico de una cola de tareas tradicional, pero construido sobre temas de Kafka comunes. Esta función llegó a disponibilidad general en la serie 4.2, ya lista para producción. Lo interesante es que achica bastante la distancia que marcamos en la tabla de comparación con RabbitMQ: el caso de "necesito una cola de tareas con reparto flexible de trabajo", que antes era terreno casi exclusivo de RabbitMQ, ahora Kafka también lo puede cubrir de forma nativa, sin recurrir al truco de crear temas con una sola partición para simular una cola simple.
Un detalle importante si te tentás a probarla desde ya: el código de acceso temprano de la 4.0 y el de preview de la 4.1 no son compatibles entre sí — no podés usar un share consumer de una versión contra un clúster de la otra. Y es más restrictivo todavía: si llegaste a habilitar share groups en un clúster 4.0, ese clúster directamente no se puede actualizar a la 4.1, porque el formato interno de los registros que usan los share groups para trackear confirmaciones cambió entre una versión y otra. Por eso Apache fue explícito en recomendar probar esta función solo en clústeres descartables, sin intención de actualizarlos después. La buena noticia es que a partir de la 4.1 el formato ya quedó estabilizado, así que de ahí en adelante sí hay camino de actualización garantizado.
Ventajas centrales
Escalabilidad horizontal real. Como las particiones se reparten entre brokers, el límite de capacidad no es "lo que aguanta un servidor", sino "lo que aguantan todos los servidores del clúster sumados". Sumar capacidad es, en gran medida, sumar más brokers.
Latencia baja. Al desacoplar productores de consumidores (unos escriben, otros leen, sin bloquearse mutuamente), Kafka puede sostener un volumen de eventos por segundo mucho mayor que un sistema donde cada mensaje espera una confirmación sincrónica de quien lo procesa.
Durabilidad. Los datos se escriben a disco y se replican entre varios brokers. Si un servidor se cae, otro que tenga una réplica de esa partición toma la posta sin perder datos — siempre que la política de replicación esté bien configurada.
Kafka vs. RabbitMQ: una comparación con matices
Es común ver esta comparación reducida a "Kafka para volumen alto, RabbitMQ para todo lo demás", pero vale la pena mirarlo con más cuidado porque no siempre es tan tajante.
| Kafka | RabbitMQ | |
|---|---|---|
| Modelo de fondo | Registro particionado (log distribuido) | Cola de mensajes tradicional |
| Retención tras leer | El mensaje queda guardado según la política de retención, incluso después de leído | El mensaje se elimina al ser consumido (por defecto) |
| Múltiples consumidores independientes del mismo flujo | Sí, de forma nativa (distintos grupos de consumidores) | Requiere configuración adicional (exchanges tipo fanout) |
| Reprocesar historial | Sí, moviendo el offset hacia atrás | No, salvo que lo hayas diseñado explícitamente vos |
| Enrutamiento de mensajes complejo (por contenido, prioridad) | Limitado, pensado para simplicidad de particiones | Muy flexible (exchanges, routing keys, colas de prioridad) |
| Mejor encaje | Streaming de eventos, pipelines de datos, event sourcing | Tareas asincrónicas puntuales, colas de trabajo con lógica de enrutamiento rica |
Un caso donde RabbitMQ suele encajar mejor que Kafka, a pesar de la fama de este último: un sistema que necesita enrutar tareas según reglas de negocio complejas (por ejemplo, "esta tarea va a la cola de prioridad alta si el cliente es premium") y donde no importa guardar el historial de mensajes una vez procesados. Ahí, la flexibilidad de enrutamiento de RabbitMQ pesa más que la capacidad de replay de Kafka.
Vale aclarar que esta tabla describe el comportamiento clásico de Kafka, con grupos de consumidores tradicionales. Más abajo, en la sección sobre las novedades de Kafka 4.0, contamos una función nueva (share groups, KIP-932) que empieza a acercar a Kafka al terreno de las colas de tareas puntuales — vale la pena leerla si el enrutamiento por competencia entre consumidores es justo lo que estás evaluando.
Casos de uso reales
Clickstream de un sitio web. Cada clic, scroll o vista de producto se publica como evento. Un consumidor alimenta el dashboard de analítica en vivo, otro entrena el modelo de recomendaciones de forma asíncrona, y un tercero simplemente archiva todo en un data lake para análisis futuro — los tres leyendo del mismo tema, sin coordinarse entre sí.
Agregación de logs de microservicios. En vez de que cada servicio escriba directamente a un sistema de logging centralizado (lo cual lo acopla a la disponibilidad de ese sistema), cada servicio publica sus logs a Kafka, y un consumidor dedicado los indexa donde corresponda. Si el sistema de indexado se cae, los logs simplemente se acumulan en Kafka hasta que vuelve a estar disponible.
Sincronización entre bases de datos (CDC — Change Data Capture). Con la Connect API, es común capturar cada cambio en una tabla de una base de datos transaccional y publicarlo como evento en Kafka, para que otros sistemas (un buscador, un caché, un data warehouse) se mantengan sincronizados sin que la base de datos original tenga que saber nada de ellos.
Cuándo Kafka no es la respuesta
Esto suele quedar afuera de los artículos introductorios, pero es tan importante como saber cuándo usarlo:
Si tu volumen de mensajes es bajo y esporádico, la complejidad operativa de mantener un clúster de Kafka (aunque hoy sea más simple gracias a KRaft) puede no justificarse frente a una cola simple o incluso una tabla de base de datos con un job programado.
Si necesitás garantías transaccionales estrictas entre el mensaje y una acción de negocio (por ejemplo, "descontá el dinero de la cuenta y mandá la confirmación, todo o nada"), Kafka puede formar parte de la solución, pero no reemplaza por sí solo un mecanismo transaccional bien pensado.
Si tu caso de uso es principalmente enrutamiento condicional de tareas (colas de prioridad, retries automáticos con lógica compleja, dead-letter queues elaboradas), herramientas como RabbitMQ o incluso una cola gestionada en la nube pueden resolverlo con menos fricción operativa.
Preguntas para hacerte antes de sumar Kafka a tu stack
¿Tengo más de un sistema que necesita enterarse del mismo evento, de forma independiente? Si la respuesta es "no, solo hay un consumidor", probablemente no necesites la capacidad de múltiples grupos de consumidores que ofrece Kafka.
¿Me importa poder reprocesar eventos históricos? Si nunca vas a necesitar "rebobinar", una cola tradicional puede ser más simple de operar.
¿Tengo (o puedo conseguir) la capacidad operativa para mantener un clúster distribuido? Aunque KRaft simplificó bastante la operación, seguís gestionando brokers, particiones y réplicas — no es gratis en términos de complejidad.
¿Mi volumen de eventos realmente necesita escalar horizontalmente? Si estás manejando unos pocos mensajes por segundo, es probable que estés pagando complejidad de infraestructura por un problema que todavía no tenés.
Si preferís no administrar vos mismo la infraestructura, servicios gestionados como Amazon MSK, Confluent Cloud o equivalentes en otras nubes se encargan de la parte operativa (parcheo, escalado, monitoreo) a cambio de una tarifa — una opción a considerar si lo que te frena es justamente el punto 3.
Para cerrar
Kafka resuelve un problema específico y lo resuelve muy bien: desacoplar a quienes generan eventos de quienes los consumen, a una escala que las colas tradicionales no pueden sostener, sin perder la capacidad de tener múltiples consumidores independientes leyendo lo mismo. No es la respuesta a "necesito mandar un mensaje de un servicio a otro" en general — para eso, muchas veces algo más simple alcanza y sobra. Es la respuesta cuando el volumen, la necesidad de múltiples suscriptores independientes, o la posibilidad de reprocesar historial, se vuelven requisitos reales de tu sistema y no solo una intuición de "esto es lo que usan las empresas grandes".


